Lokale KI für Windows · Research Beta
Fragen Sie Ihre Dateien. Nichts verlässt Ihren PC.
StarkLLM indexiert Ihre Dokumente auf Ihrem eigenen Rechner und antwortet mit seitengenauen Quellenangaben, mit Ollama-Modellen, die Sie selbst betreiben.
- DateienPDF, Word, Text, Code
- ChunksNach Sinn geteilt, nicht nach Länge
- HybridsucheBM25 + Vektor-Embeddings
- Lokales ModellOllama auf Ihrer GPU
- Belegte AntwortDirekt zur Quellseite
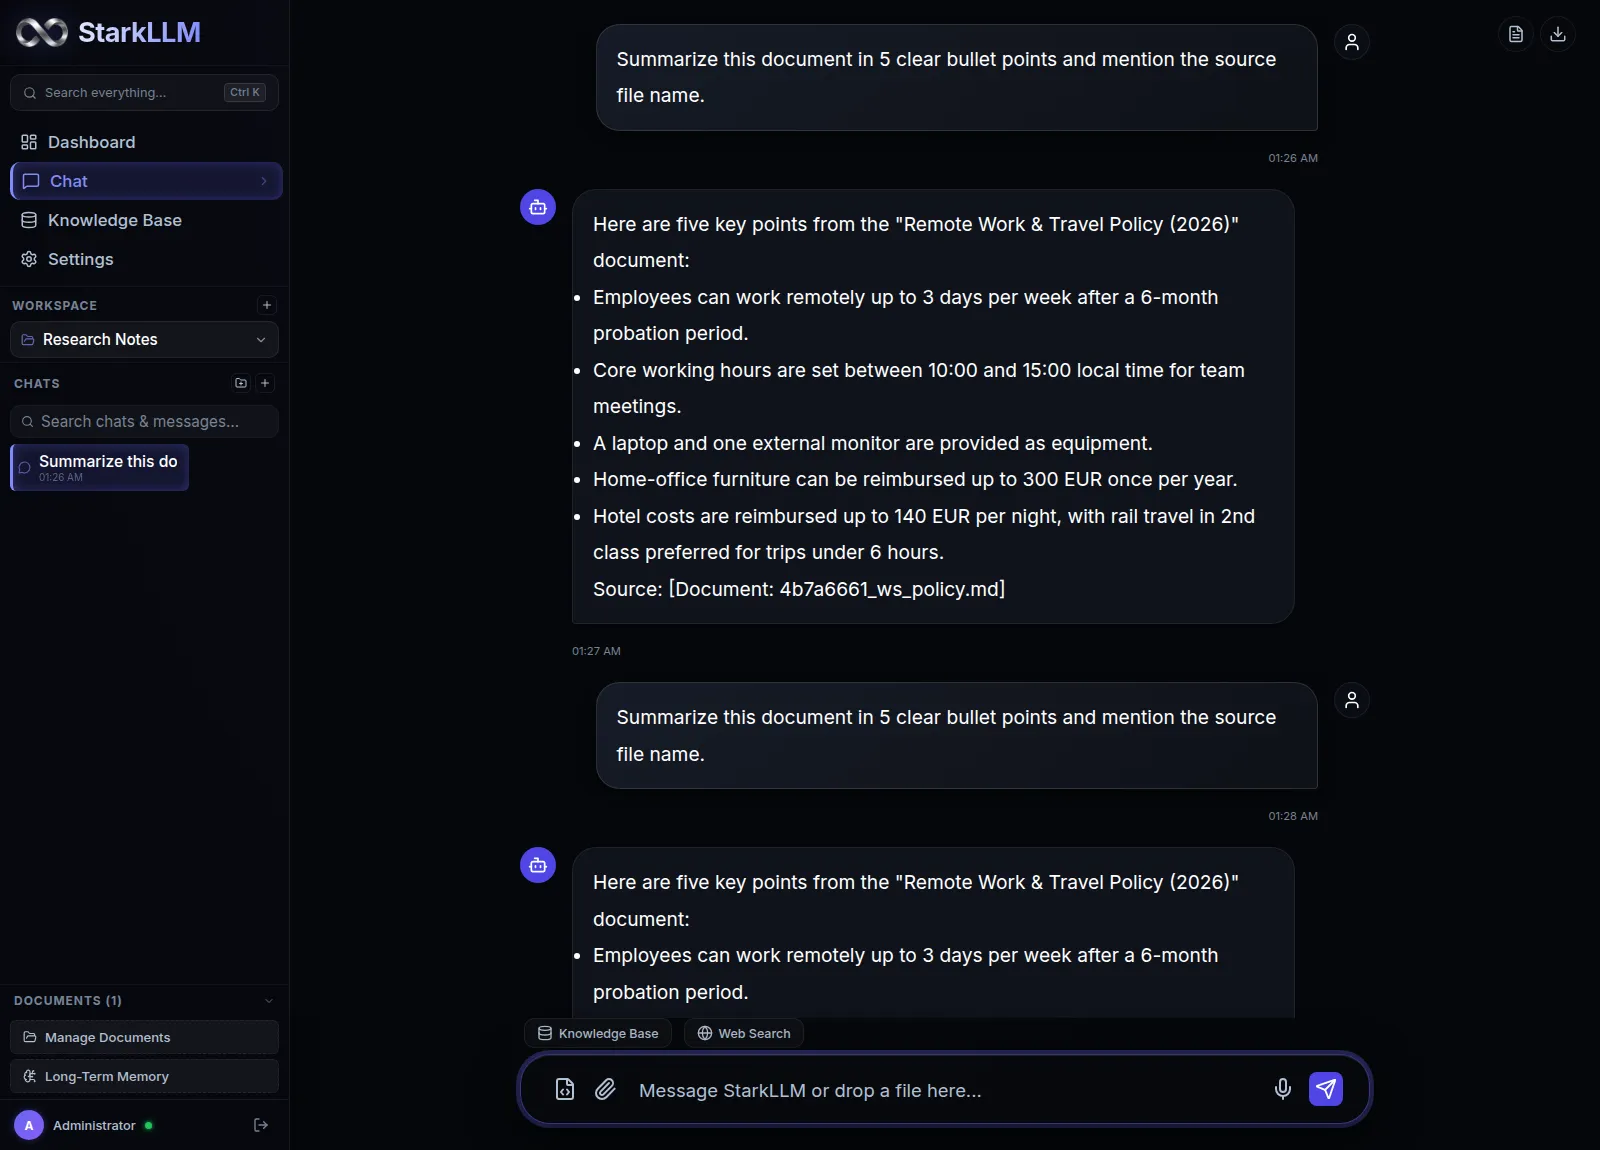
Für alle, die ihre Dokumente nicht hochladen können.
Hybrides RAG mit Cross-Encoder-Reranker
Stichwort- und semantische Suche laufen zusammen; ein TinyBERT-Cross-Encoder sortiert die Passagen, die die Frage wirklich beantworten.
Ein echtes App-Fenster
Eigenes Fenster mit Startbildschirm und Tray-Menü. Kein Browser-Tab.
Lokale Tools mit Bestätigung
Nur lesende Tools wie search_local_kb und fetch_cited_chunk. Jeder Aufruf braucht Ihre Bestätigung und ein Einmal-Token.
Acht Themes, sofort umschaltbar
Midnight Indigo, OLED Pitch Black, Liquid Glass, Cyberpunk Rose, Matrix Emerald, Sunset Amber, Arctic Frost und Daylight Minimal.
Workspaces und globale Wissensdatenbank
Windows-Ordner einbinden, Projekte getrennt halten und die gemeinsame Wissensdatenbank aus jedem Chat abfragen.
Lokale Python-Sandbox
Ausführung im Prozess mit AST-Prüfung und Zeitlimit.
Lokaler OpenAI-kompatibler Server
Ein Standard-Endpunkt /v1/chat/completions für Cursor, Claude Code und andere Tools.
StarkLLM im Vergleich
Ein ehrlicher Blick darauf, wo StarkLLM neben anderen beliebten offenen Lösungen steht.
| Tool | Stärken und Grenzen | Am besten für |
|---|---|---|
| Inferenz-GUILM Studio | Hervorragend zum Laden von GGUFs von Hugging Face und zum Feinjustieren der GPU-Auslagerung. Es fehlen tiefes RAG über mehrere Dokumente, dauerhafte Workspace-Wissensdatenbanken und sichere Code-Ausführung. | GGUF-Modelle ohne Dokumentbezug testen. |
| Einfache RAG-AppAnythingLLM | Beliebt für Desktop-RAG, nutzt aber einfaches Chunking ohne Cross-Encoder-Reranking, was bei dichten technischen Dokumenten zu Fehlern in der Suche führen kann. Läuft in einem schwereren Web-Dashboard. | Lockere Dokument-Chats, bei denen Präzision nicht kritisch ist. |
| Minimaler ChatJan.ai | Eine leichte, telemetriefreie Open-Source-App im ChatGPT-Stil. Es fehlen fortgeschrittenes Hybrid-RAG, Cross-Encoder-Reranking, Code-Sandbox im Prozess und multimodale Dokumentanalyse. | Einfacher telemetriefreier Chat ohne Dokument-Workflows. |
| Dieses ProjektStarkLLM v2.0.0 | Native Windows-Desktop-App mit Hybrid-RAG und TinyBERT-Cross-Encoder-Reranking, sicherer Python-Sandbox, lokalem OpenAI-Server (/v1) und Datenschutz ohne Cloud. | Entwickler, Forschende und datenschutzkritische Fachleute, die geprüfte Genauigkeit brauchen. |
In etwa fünf Minuten eingerichtet
Sind Docker, Ollama und die Modelle bereits installiert, dauert die Einrichtung etwa 5 Minuten. Der erste Download von Modellen und Docker-Images hängt von Ihrer Bandbreite ab.
- Docker Desktop startenStellen Sie sicher, dass es im Infobereich läuft.
- Ollama installieren und Modelle ladenFühren Sie im Terminal aus:
ollama pull qwen2.5:7b
ollama pull nomic-embed-text
- StarkLLM-Installer ausführenStarkLLM-v2.0.0-Setup.exe herunterladen und starten, oder die portable Version nutzen. Der Assistent legt die Verknüpfungen an.
- StarkLLM startenKlicken Sie auf die Desktop-Verknüpfung. Die Dienste starten automatisch.
Wichtige Hinweise
Erster Start. Er kann einige Minuten dauern, während Docker-Images geladen werden. Sobald die Container laufen, braucht das Backend eventuell noch 1–2 Minuten.
Windows SmartScreen. Wird die Ausführung blockiert, wählen Sie „Weitere Informationen“ und dann „Trotzdem ausführen“.
Hardware zählt. Geschwindigkeit und Antwortqualität hängen stark von einer leistungsfähigen GPU ab (8 GB+ VRAM empfohlen).
Die Architektur der Privatsphäre
StarkLLM ist eine Offline-Alternative zu Cloud-KI-Diensten. Ihre Dokumente, Schriftsätze und Recherchen bleiben auf Ihrem Rechner.
Lokale Inferenz
Mit Ollama laufen Sprachmodelle auf Ihrer eigenen CPU oder GPU. Nach dem Download der Modelle ist der Betrieb vollständig offline möglich.
Lokaler Speicher
Dokumente werden in Chunks zerlegt und in einen lokalen ChromaDB-Vektorspeicher in einem isolierten Docker-Container eingebettet.
Keine Telemetrie
Die Windows-App enthält weder Telemetrie noch ein Analyse-SDK. Diese Website nutzt selbst gehostetes Umami; siehe Datenschutzerklärung.
Jetzt installieren.
Kostenlos und quelloffen unter Apache 2.0.
- Betriebssystem: Windows 10/11 mit aktiviertem WSL2
- Docker Desktop: installiert und gestartet
- Ollama: auf dem Windows-Host installiert
- Hardware: mind. 8 GB RAM, empfohlen 16 GB, NVIDIA-GPU mit 8 GB+ VRAM empfohlen
e6b29e6b77788dfd85eaa1e3e96634f38c97f1d4ed993b6ff6057340d4a457b5a0c8b569d554ee345802f832ece80fad01f4db378c126576ac6685be78aaeda9Prüfen mit PowerShell: Get-FileHash -Algorithm SHA256 StarkLLM-v2.0.0-Setup.exe